MuRing-KB 개발기 1 (구축 편)
같은 오류를 AI에게 매번 다시 설명하지 않으려고 Markdown과 Git으로 지식 저장소를 만들었다


개발자로 일한 지 2년 가까이 됐다. 그 시간의 꽤 많은 부분이 같은 오류를 다시 만나고, 같은 작업을 다시 하는 데 들어갔다는 걸 요즘 들어 알았다. AI를 쓰면서 더 선명해졌다. 지난번에 풀었던 문제를 AI에게 또 처음부터 설명하고 있었으니까.
가장 최근 사례는 이거였다. WSL을 새로 구축하고 Windows 쪽에 설치한 Orca와 연동하는데, 워크트리 이름 생성 오류가 났고 그 뒤로 CLI 연동 오류가 몇 개 더 따라왔다. 하나씩 원인을 찾아 고쳤다. 그런데 그 과정은 대화 안에만 남았다. 세션이 끝나면 다음 세션의 AI는 그걸 모른다. 나도 며칠 지나면 "뭔가 고쳤는데" 이상은 기억 못 한다.
그 무렵 토스의 개발자들이 지식 저장소를 만들어 쓴다는 이야기를 들었다. 마침 개발 환경 설치를 자동화하는 dev-bootstrap을 만들던 참이었다. 환경을 자동으로 세팅할 거면, 그 환경에서 얻은 지식도 같이 따라다녀야 하지 않나.
"설치는 자동화하면서 삽질은 매번 수동으로 반복할 건가."
그래서 dev-bootstrap과 같이 지식 저장소도 만들기로 했다. 조건은 셋이었다. AI가 읽을 수 있고, 어느 PC에서든 같고, 특정 도구에 종속되지 않을 것. 이름은 MuRing-KB로 정했다.
이 글은 그 저장소를 처음 만든 나흘의 기록이다. 커밋은 17개, 도구 버전은 0.1.0에서 0.10.0까지 올라갔다.
무엇을 원본으로 삼을 것인가
가장 먼저 정한 건 "원본이 어디에 있느냐"였다. 선택지는 셋이었다.
| Markdown + private Git | AI가 상시 갱신하는 저장소 | 업무 자료까지 한 곳에 통합 | |
|---|---|---|---|
| AI가 읽는 방법 | 로컬 파일 그대로 | 로컬 파일 그대로 | 로컬 파일 그대로 |
| 기록 부담 | 내가 검토하고 반영 | 거의 없음 | 내가 검토하고 반영 |
| 위험 | 수동 동기화, 충돌 | 검토 안 된 내용이 원본에 섞임 | 자료별 접근 경계가 무너짐 |
| PC 간 이동 | git pull | git pull | git pull |
Markdown과 Git을 골랐다. 이유는 하나다. 일반 텍스트와 상대 링크는 도구를 바꿔도 살아남는다. 오늘 Codex와 Claude Code를 쓰지만 내년에 뭘 쓸지는 모른다. 어떤 AI든 로컬 파일은 읽는다.
"AI가 알아서 갱신"은 매력적이었지만 첫날부터 켜지는 않았다. 검토되지 않은 결론이 원본에 들어가면, 다음 세션의 AI가 그걸 사실로 믿고 또 다른 결론을 쌓는다. 틀린 지식이 복리로 불어난다. 그래서 AI는 읽고 제안하고, 원본은 내가 승인한 범위에서만 바꾼다를 첫 규칙으로 뒀다.
업무 자료는 아예 별도 저장소로 뺐다. 개인 저장소에는 공개해도 되는 일반 지식만 둔다. 경계가 애매한 건 안 넣는다.
폴더는 이렇게 됐다.
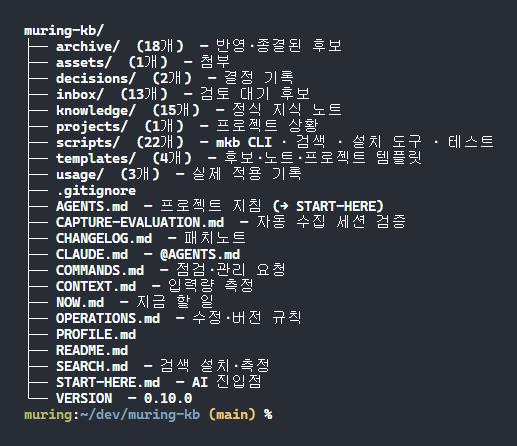
"저장소 구조. 정식 지식과 후보, 결정 기록이 폴더로 나뉜다"
knowledge/가 정식 지식이고, decisions/는 "왜 그렇게 했는지"의 기록이다. projects/는 프로젝트별 상황이고, inbox/와 archive/는 뒤에서 설명할 후보 수집함이다. 지금 정식 노트는 15개, 결정 기록은 2개다.
결정 기록에는 채택하지 않은 대안도 적는다
decisions/ 폴더를 따로 둔 이유는 한 가지다. 나중에 "왜 이렇게 했더라"를 다시 묻지 않으려고. 위의 표도 결정 기록에서 그대로 가져온 것이다.
결정 문서에는 상황, 선택, 검토한 대안, 이유와 비용, 그리고 재검토 조건을 적는다. 예를 들어 "문서가 늘어서 본문 검색만으로 못 찾게 되면 검색 도구를 다시 검토한다"처럼. 재검토 조건이 있으면 결정이 영원한 게 아니라는 걸 문서가 스스로 말해준다.
진입점 하나로 컨텍스트 줄이기
저장소를 만들었으면 AI가 그걸 읽게 해야 한다. 여기서 두 번 고쳤다.
전역 지침에는 "여기부터 읽어라" 한 줄만
Codex는 ~/.codex/AGENTS.md를, Claude Code는 ~/.claude/CLAUDE.md를 모든 세션에서 읽는다. 처음엔 여기에 저장소 사용법을 통째로 넣었다. 그러자 모든 세션이, 관련 없는 질문에도 그 지침을 먼저 삼켰다.
0.4.0에서 구조를 바꿨다. 전역 지침에는 "세션 첫 작업 전에 START-HERE.md를 한 번 읽어라"만 남기고, 절차는 상황별 문서로 쪼갰다. START-HERE는 33줄이다. 후보 기록 절차, 사용 기록, 검색 설치 같은 건 필요한 상황에만 읽도록 표로 연결했다.
| 토크나이저 | 이전 | 변경 후 | 감소 |
|---|---|---|---|
| o200k_base | 3,517 | 987 | 71.9% |
| cl100k_base | 5,155 | 1,437 | 72.1% |
전역 등록 구간과 START-HERE를 합쳐 잰 값이다. 텍스트 크기 비교일 뿐 실제 과금이 72% 줄었다는 뜻은 아니다. 대화 이력이나 도구 형식은 이 숫자에 없다. 그래도 세션마다 3,500토큰을 무조건 넣던 걸 1,000으로 줄인 건 체감이 됐다.
지침을 두 벌 복사하지 않기로 했다
Codex와 Claude Code 양쪽에 등록하는 setup.py --client all을 0.9.0에 만들었다. 그때는 같은 지침을 두 파일에 각각 복사했다. 하루 뒤 문제가 보였다. 지침을 고치면 두 곳을 같이 고쳐야 하고, 한쪽만 고치면 두 도구가 서로 다른 규칙으로 움직인다.
0.10.0에서 복사를 없앴다. Claude Code 쪽 관리 구간에는 한 줄만 둔다.
<!-- muring-kb:begin -->
@/home/muring/.codex/AGENTS.md
<!-- muring-kb:end -->
Claude Code의 @ 가져오기로 Codex 파일을 그대로 읽는다. 원본은 하나, Codex의 AGENTS.md다. 대신 제약이 생겼다. --client claude만 실행하면 Codex 등록이 먼저 있어야 하고, Codex 폴더 경로에 공백이 있으면 가져오기 줄이 깨지므로 설치를 거부한다. 이 두 조건은 테스트로 박아뒀다.
"두 벌 유지하는 건 결국 한 벌은 틀린다는 뜻이다."
AI가 쓰되 원본은 건드리지 않는다
이 저장소의 핵심은 여기다. 지식을 손으로 옮겨 적는 저장소는 안 굴러간다. 내가 안 적는다. 그렇다고 AI가 정식 문서를 직접 고치게 두면 첫 절에서 말한 복리 오염이 생긴다.
그래서 후보라는 중간 단계를 뒀다.
정식 지식과 후보를 분리했다
세션에서 문제를 고치고 검증까지 끝나면, AI는 inbox/에 후보 파일 하나를 새로 만든다. 정식 문서는 건드리지 않는다. 후보는 템플릿이 정해져 있다. 상황과 환경, 재사용 가치, 확인된 결과, 근거, 아직 확인하지 못한 부분, 관련 문서. 미확인 항목을 반드시 적게 한 이유는 후보가 정식 지식보다 약한 근거라는 걸 문서 자체가 드러내야 하기 때문이다.
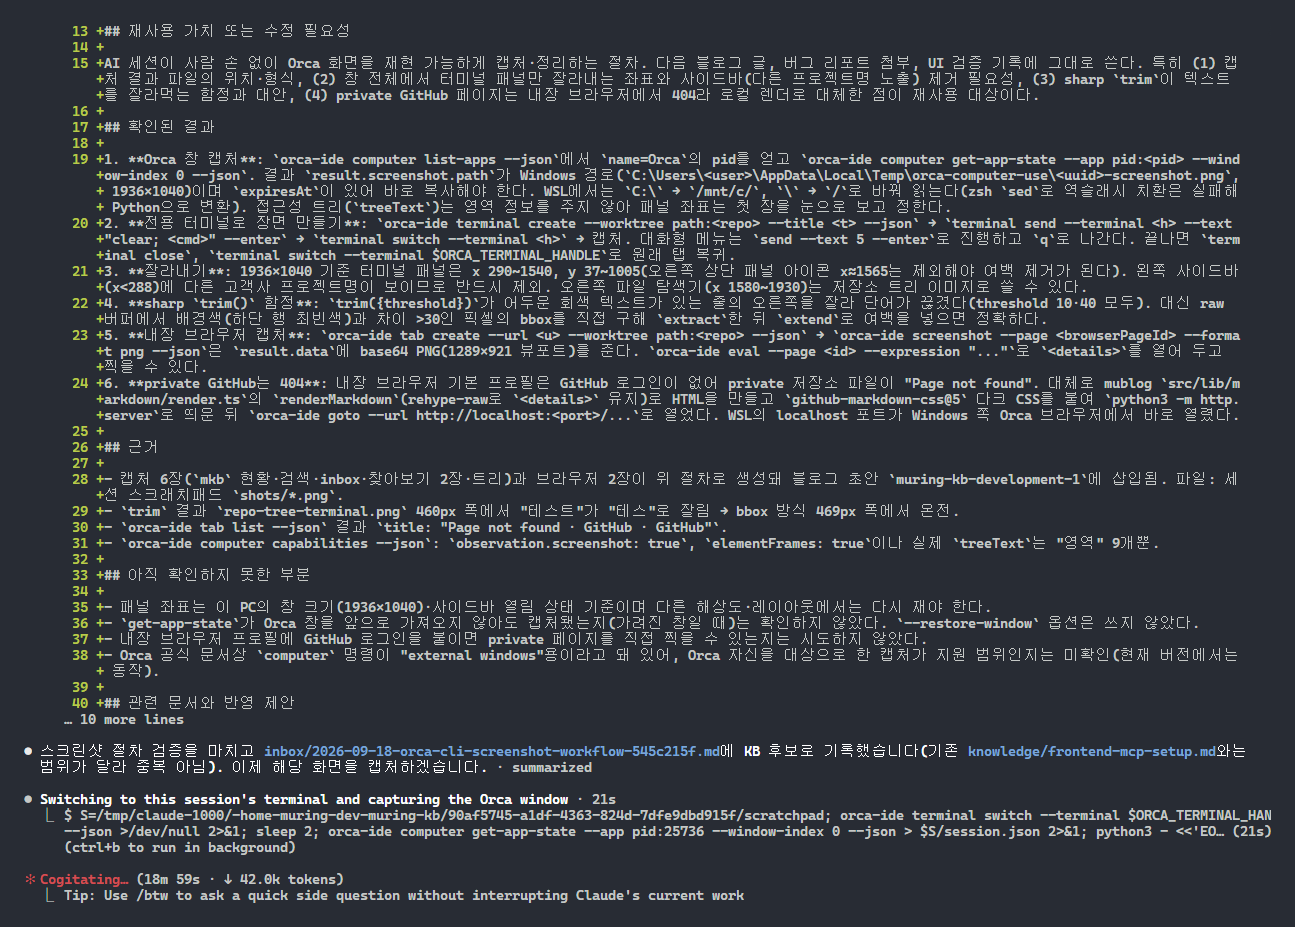
"세션이 끝날 무렵 후보 파일이 만들어지고, 경로가 응답에 남는다"
후보는 네 가지 상태를 가진다.
| 상태 | 의미 |
|---|---|
| 대기 | 수집됨, 아직 검토 안 함 |
| 반영 완료 | 정식 문서에 넣고 링크까지 확인 |
| 중복 종결 | 기존 문서로 충분해서 생략 |
| 보류 | 근거 부족이나 충돌 |
내가 "inbox 후보를 정리해줘"라고 하면 AI는 대기 후보를 기존 문서와 비교해 추가·보완·중복·보류로 나눈 표를 제안만 한다. 파일은 안 바꾼다. 내가 항목을 골라 "이거 반영해줘"라고 해야 정식 문서가 바뀌고, 처리된 후보는 archive/inbox/로 옮겨진다. 0.2.0에서 이 archive 이동을 넣었고, 그때 반영 완료 후보 5개를 옮기고 보류 4개는 남겼다.
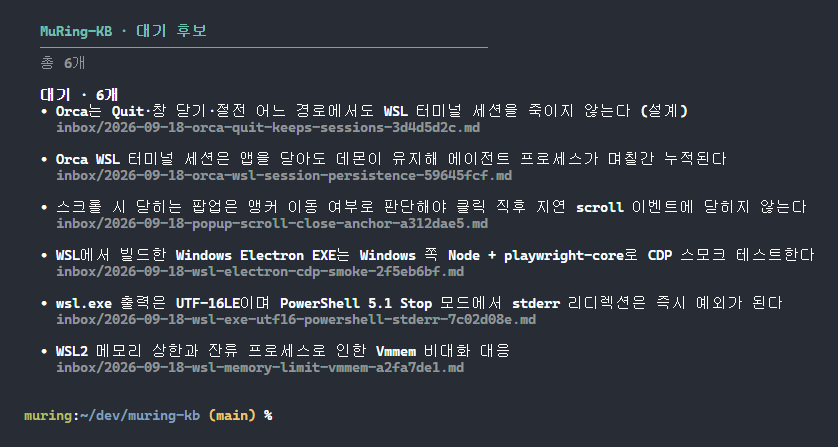
"mkb inbox. 오늘 아침 세션에서 쌓인 대기 후보 6개"
수집 기준을 한 번 조였다
처음 지침은 "확인된 결과와 확정된 결정을 수집한다"였다. 하루 써보니 잡음이 섞였다. "설치 위치는 선택지를 제시한 뒤 결정한다" 같은 건 그 프로젝트의 요구사항이지 재사용할 지식이 아니다. 완료 보고도 후보로 들어왔다.
0.4.0과 0.9.0에서 기준을 바꿨다. "어떤 미래 작업에서 무엇을 재사용할지 설명할 수 있을 때만" 수집한다. 단순 요구사항, 완료 보고, 프로젝트 README에 이미 있는 동작 설명은 뺀다. 대신 근거가 있는 기존 문서의 오류는 재사용 여부와 상관없이 수정 검토 후보로 받는다.
후보를 만들기 전에는 정식 문서, 현재 inbox, archive를 전부 검색해서 같은 결과가 있으면 생략한다. archive에 같은 주제가 있어도 새 근거나 조건 변경이면 이전 기록을 링크한 새 후보를 만든다. 기존 후보는 수정하지 않는다. 다른 세션이 같은 시각에 쓰고 있을 수 있어서다.
지침이 정말 지켜지는지는 따로 확인했다
지침을 써놓는 것과 AI가 그대로 움직이는 것은 다른 문제다. 그래서 0.9.0에서 격리된 환경으로 검증을 돌렸다. 임시 프로필과 빈 저장소를 만들고, 후보 생성을 지시하지 않은 채 CSV 오류 수정만 시켰다. Codex와 Claude Code 각각 세 세션, 총 여섯이다.
| 검증 | Codex | Claude Code |
|---|---|---|
| 첫 작업에서 진입 문서 읽기 | 확인 | 확인 |
| 생성 전 정식·inbox·archive 검색 | 확인 | 확인 |
| 수정·검증 후 요청 없이 후보 생성 | 1개 | 1개 |
| 같은 코드 단순 재확인 | 추가 0개 | 추가 0개 |
| 다른 프로젝트에서 같은 오류 수정 | 중복 생략 | 중복 생략 |
| 정식 노트 자동 생성·수정 | 없음 | 없음 |
첫 후보 파일의 SHA-256이 이후 세션에서 바뀌지 않은 것까지 확인했다. 여섯 세션이면 표본이 작다. 그래서 문서에도 "짧은 새 세션에서 확인했다"까지만 적었고, 긴 세션과 문맥 압축, 다른 PC에서의 수집 누락률은 재지 않았다고 남겼다. 한 가지 더 있다. 후보가 만들어졌다는 것과 후보 내용이 맞다는 건 다른 문제였다. 한 세션의 후보에는 부정확한 설명이 섞여 있었고, 따로 실행해서 잡았다. 자동 수집이 되더라도 검토 단계를 없앨 수 없는 이유다.
"검증 안 한 건 안 한 거다. 됐을 것 같다는 말은 문서에 못 쓴다."
mkb, 검색과 탐색
Markdown 파일이 서른 개를 넘기자 AI가 "관련 문서를 찾아 읽어라"를 어떻게 수행하는지가 문제가 됐다. rg로 키워드를 찾는 건 되지만, "자동 제목 생성 오류"를 "이름이 안 만들어지는 문제"로 물으면 못 찾는다.
검색은 로컬에서, 모델은 매번 띄운다
0.3.0에서 mkb search를 만들었다. 키워드 검색에 로컬 벡터 검색을 섞은 하이브리드다. 모델은 multilingual-e5-small이고 별도 Python 3.12 환경에 고정 버전으로 설치한다. 문서와 검색어는 외부로 안 나간다.
성능은 정직하게 적어둬야 한다. 모델을 매 검색마다 로딩하고 종료하기 때문에 한 번 검색에 15~19초가 걸렸다. 로딩만 13.5초다. 백그라운드 서버를 띄우면 빨라지지만 그러면 "설치하면 끝"이 아니게 된다. 정확한 용어를 아는 경우를 위해 --keyword를 남겼고, 모델이 없으면 자동으로 키워드 결과와 안내를 준다.
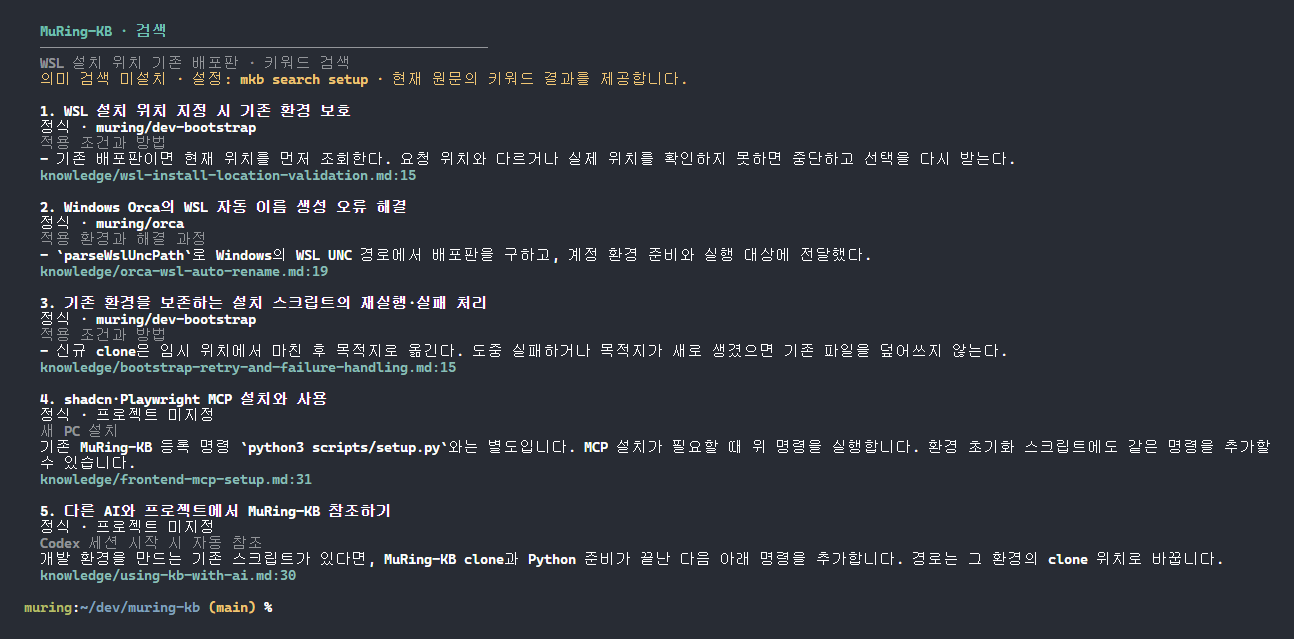
"mkb search. 이 PC에는 아직 모델을 안 깔아서 키워드 모드로 떨어졌다"
결과에는 경로와 줄 번호, 소제목, 후보 상태가 같이 나온다. AI는 검색 결과만 믿지 말고 그 절부터 읽고 적용 조건과 한계까지 확인하도록 지침에 적어뒀다. 검색 결과는 후보일 뿐이다.
프로젝트 식별자를 외우게 하지 않았다
처음 검색 필터는 --project muring/orca처럼 식별자를 직접 넣는 방식이었다. AI는 잘 쓴다. 나는 못 쓴다. 식별자를 매번 잊어버렸다.
0.5.0에서 대화형 선택을 넣었다. 검색어 없이 mkb search만 치면 프로젝트 목록이 뜬다.
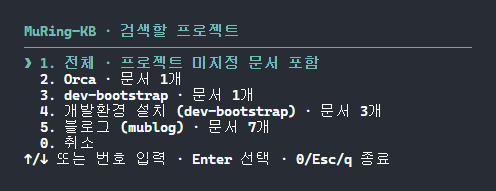
"프로젝트 선택. 문서 수가 같이 보인다"
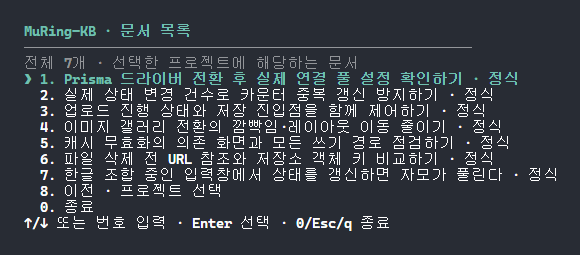
"고르면 그 프로젝트의 문서 목록이 나오고, 하나를 고르면 원문을 읽는다"
0.5.1에서 오류 메시지에 남아 있던 "식별자를 입력하세요" 안내를 지웠다. 사용자용 명령은 식별자를 요구하지 않는다는 규칙을 운영 문서에도 넣었다. --project는 AI와 스크립트용으로 고급 도움말에만 남겼다.
방향키와 번호를 같이 받는다
0.7.0에서 ↑/↓ 선택을 넣었더니 0.7.1에서 바로 번호를 되살려야 했다. 방향키 메뉴만 있으면 항목이 열 개일 때 아홉 번 눌러야 한다. 번호 입력만 있으면 목록을 눈으로 세야 한다. 결국 둘 다 받게 했다. 번호를 치면 그 항목으로 커서가 가고, 방향키를 누르면 입력한 숫자는 지운다. 0은 어디서나 취소다.
이 메뉴 코드가 mkb check의 등록 확인에도 쓰이도록 0.7.2에서 통일했다. 한 도구 안에서 질문 방식이 화면마다 다르면 그것도 학습 비용이다.
테스트가 색깔 때문에 깨졌다
0.10.0 직후의 커밋은 다섯 줄짜리 수정이다. 문서 탐색 테스트가 색을 쓰는 터미널에서만 깨졌다. 테스트가 가짜 TTY를 쓰는데, TTY라고 판단되면 출력에 색 코드가 붙고, 평문을 기대하는 단언이 어긋난 것이다.
# The fake TTY turns colors on; pin NO_COLOR so plain-text assertions match everywhere.
env = patch.dict(os.environ, {'NO_COLOR': '1'})
env.start()
self.addCleanup(env.stop)
NO_COLOR를 고정하는 걸로 끝났다. 환경마다 다르게 동작하는 테스트는 통과했을 때도 무슨 환경에서 통과했는지 모른다는 뜻이다. 지금 자동 테스트는 90개다.
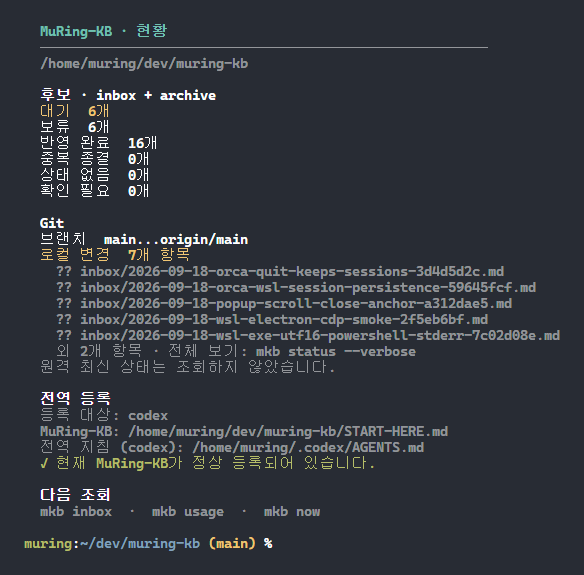
"mkb 현황. 후보 상태별 개수와 Git 상태, 전역 등록 여부를 한 화면에"
버전을 올리는 이유
나흘 동안 버전이 16번 바뀌었다. 개인 도구에 패치노트가 과하다는 건 안다. 그래도 붙였다.
이유는 다른 PC다. 노트북에서 git pull을 받았을 때 "뭐가 바뀌었길래 지침이 다르지"를 알아야 한다. 그래서 큰 기능이나 운영 방식이 바뀔 때마다 VERSION을 올리고, CHANGELOG에 변경·검증·이관 영향을 적고, README를 같이 고치는 걸 규칙으로 뒀다. 항목마다 "자동 테스트 몇 개 통과"와 "실제로 확인한 것"을 나눠 적는다. 안 한 검증은 안 했다고 쓴다.
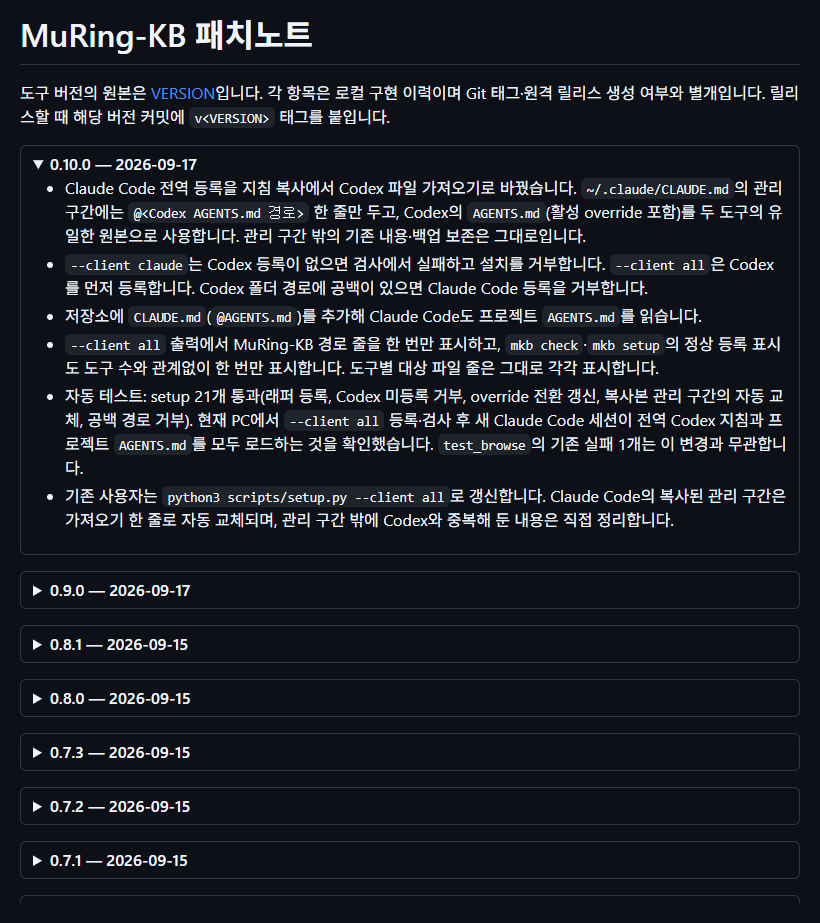
"CHANGELOG. 버전마다 접혀 있고, 검증한 범위와 안 한 범위를 같이 적었다"
Git 태그는 안 붙였다. 릴리스라고 부를 만한 게 아직 없어서다. VERSION 파일 하나가 원본이다.
결과
첫날과 지금을 비교하면 이렇다.
| 만들기 전 | 지금 | |
|---|---|---|
| 지난 세션의 결론 | 대화 안에서 증발 | inbox/에 후보로 남음 |
| 다른 PC에서 | 같은 조사를 다시 함 | git pull 후 같은 문서 |
| 도구가 다르면 | Codex와 Claude Code가 서로 모름 | 전역 지침 원본 하나를 둘이 읽음 |
| 정식 문서 변경 | 없음 (안 적었으니까) | 내가 승인한 항목만 반영 |
| 세션 시작 비용 | 지침 3,500토큰 | 1,000토큰 + 필요할 때만 상세 |
| 찾기 | rg | mkb search, 프로젝트별 탐색 |
정식 지식 15개, 결정 2개, 반영 완료 후보 16개, 대기 6개, 보류 6개. 이 글을 쓰는 오늘 아침에도 WSL 메모리 문제를 조사하다 후보 세 개가 쌓였다. 내가 적은 게 아니다. 세션이 끝날 때 거기 있었다.
아직 안 된 것도 있다. 같은 지식 노트를 둘 이상의 실제 프로젝트에서 참조한 사례가 아직 없다. 대기 후보 6개는 정리 전이다. 이 PC에는 검색 모델을 아직 안 깔았다. 이건 다음 편에 쓸 수 있으면 좋겠다.
느낀점
- AI가 쓰게 하되, 정식 문서와 분리해야 굴러간다. 손으로 옮기는 저장소는 내가 안 옮긴다. AI가 정식 문서를 직접 고치는 저장소는 틀린 걸 믿게 된다. 후보 단계 하나가 그 둘 사이를 갈랐다.
- 지침보다 검증이 먼저다. "후보를 자동 수집한다"고 써두는 건 쉽다. 격리된 여섯 세션에서 실제로 그렇게 움직이는지 보고 나서야 문서에 "확인했다"를 쓸 수 있었다.
- 원본은 하나여야 한다. 지침을 두 도구에 복사한 지 하루 만에 어긋날 조짐이 보였다.
@한 줄로 바꾼 뒤로는 고칠 곳이 한 군데다. - 미확인 항목을 적는 칸이 있어야 정직해진다. 후보 템플릿에 "아직 확인하지 못한 부분"을 필수로 두니, 글도 문서도 "될 것 같다"를 못 쓰게 됐다.
- 개인 도구에도 패치노트는 필요하다. 다른 PC에서 pull 받은 뒤 뭐가 바뀌었는지 모르면, 그 저장소는 한 PC짜리다.
나흘짜리 저장소라 아직 얇다. 그래도 세션이 끝난 뒤에 뭔가가 남는다는 것, 그게 시작으로는 됐다.
여기까지 읽어주신 분들께 감사드린다.


댓글